推理引擎优化
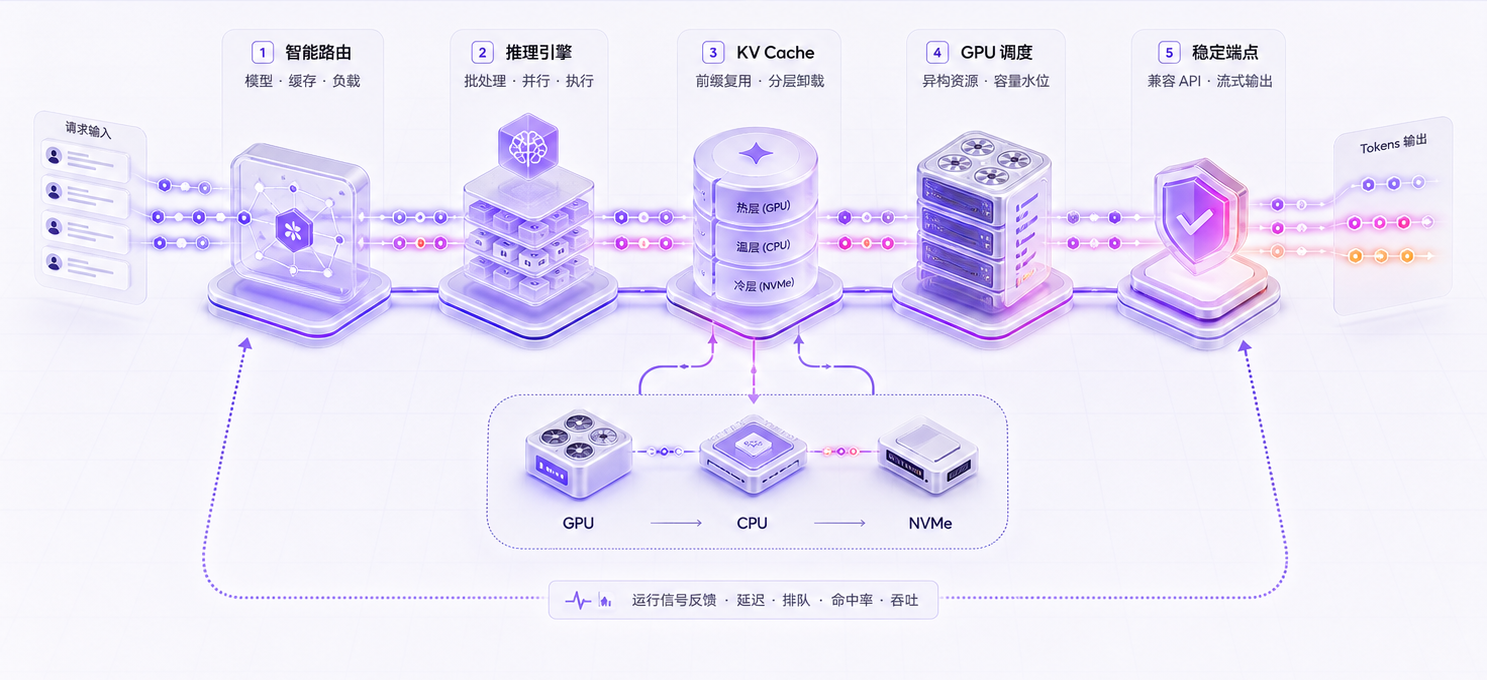
协同连续批处理、并行与执行策略,让计算路径更贴合真实流量。
缩短等待 · 提升有效吞吐
Token 工厂把请求路径、缓存层级、算力容量与运行反馈收敛成一个持续优化的控制平面。
协同连续批处理、并行与执行策略,让计算路径更贴合真实流量。
缩短等待 · 提升有效吞吐在 GPU、CPU 与 NVMe 间复用可复用前缀,减少重复计算与显存压力。
提高命中 · 释放显存按模型规模、上下文和并发把请求匹配到合适的异构算力池。
减少闲置 · 避免热点用延迟、吞吐、缓存命中和资源水位持续校准路由与容量。
持续校准 · 稳定服务市场调研背景:硬件约占 Token 生产成本的 80%;实际成本与优化收益取决于模型、硬件和流量特征,不构成性能、价格或 SLA 承诺。
已按 2026 年 8 月 18 日厂商正式开放权重发布核验。以下配置用于前期容量规划,不代表实时库存或性能承诺。
Qwen3.8-Max 基于此开放权重增加托管功能。
FP8 权重;完整长上下文需单独预留 KV cache。
长上下文或高吞吐生产服务建议多节点扩展。
MXFP4 权重与 MXFP8 激活,按多节点规划。
原始 BF16 权重;生产并发需额外显存余量。
MoE 的激活参数影响每个 token 的计算量,但总权重、KV cache、精度和并发共同决定实际显存。
前沿 MoE 的低精度权重可从高显存节点起步。
Qwen3.8 · DeepSeek-V4-Pro-0813混合精度可降低权重占用,生产负载仍需实测。
MiniMax-M3总权重大,需要高速互联与专门的容量规划。
GLM-5.2 · Kimi-K3容量估算,不是 SLA。最低可加载不等同于稳定服务;实际配置需结合权重精度、推理引擎、上下文、并发和网络拓扑验证。
这段演示呈现未来计划中的产品体验:选择模型、配置算力、由 ApiGo 托管部署,再把 Endpoint 连接到你的应用。
浏览主流开放模型,找到适合业务的选择。
ApiGo 负责资源准备、运行优化与日常管理。
通过 OpenAI 兼容 API 集成并开始构建。


